 しがないRAG屋さん
BM25は、キーワード検索で、質問に対して各文書がどれだけ関係しているかを点数にする方法です。1990年代にRobertsonらが開発し、ElasticsearchやOpenSearchなどの検索エンジンでも標準の方法として使われています。RAGのハイブリッド検索でも、キーワード検索側にBM25を使うことが多いです。
前回の記事では、キーワード検索とベクトル検索を組み合わせるハイブリッド検索を説明しました。
何のために使うのか
単純なキーワード検索は、質問の単語を含む文書をすべて同じように扱います。これでは、次のような区別ができません。
- 単語が1回だけ出てくる文書と、何度も出てくる文書
- 「の」「する」のようにどの文書にも出てくる単語と、「E-1024」のように特定の文書にしか出てこない単語
- 短い文書の中に出てくる単語と、とても長い文書の中にたまたま出てくる単語
BM25は、これらを考慮して点数を付けることで、関係の深い文書が上位に来るようにします。
どう動くのか
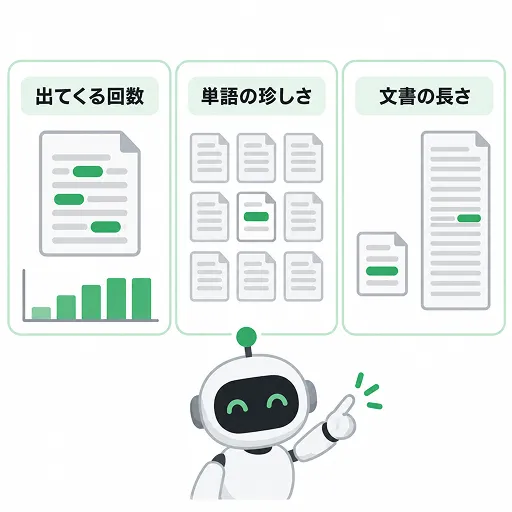
BM25は、質問に含まれる単語ごとに点数を計算し、それを合計して文書の点数にします。1つの単語の点数は、次の3つで決まります。
1. 単語が何回出てくるか
文書の中に質問の単語が多く出てくるほど、点数が高くなります。ただし、回数に比例して増え続けるわけではありません。1回目から2回目で大きく増え、10回目から11回目ではほとんど増えないように、増え方がだんだん小さくなります。同じ単語を何度も繰り返しただけの文書が上位を占めないようにするためです。
2. 単語がほかの文書にどれだけ少ないか
多くの文書に出てくる単語ほど点数を低く、少ない文書にしか出てこない単語ほど点数を高くします。これをIDF(逆文書頻度)と呼びます。どこにでも出てくる単語は、文書を見分ける手がかりにならないためです。
3. 文書の長さ
長い文書ほど、質問の単語がたまたま含まれやすくなります。そのため、平均より長い文書では点数を下げ、短い文書では上げるように調整します。
2つのパラメータ
BM25には、調整用のパラメータが2つあります。
| パラメータ | 意味 | よく使われる値 |
|---|---|---|
| k1 | 回数が増えたときに、点数がどこまで増えるか。大きいほど回数の影響が大きくなる | 1.2 |
| b | 文書の長さをどれだけ考慮するか。0なら考慮せず、1なら最も強く考慮する | 0.75 |
Apache Lucene(ElasticsearchやOpenSearchの土台になっている検索ライブラリ)の初期値も、k1が1.2、bが0.75です。まずはこの値で試し、必要なら調整します。
日本語で使うときの注意点
- 単語に区切る処理が必要:BM25は単語ごとに点数を計算しますが、日本語は単語の間に空白がありません。文章を単語に区切る形態素解析(SudachiやMeCabなど)か、数文字ずつ区切るn-gramを使います。
- 区切り方で結果が変わる:形態素解析では、辞書にない専門用語や製品名が細かく分かれてしまい、うまく一致しないことがあります。n-gramは辞書に頼らず一致しやすい一方、関係のない文書も拾いやすくなります。
- 表記の違いはそのままでは吸収できない:「サーバー」と「サーバ」、全角と半角などは別の単語として扱われます。区切る前に表記をそろえる(正規化する)か、ベクトル検索と組み合わせて補います。
Pythonで試すなら、rank_bm25 というライブラリで手軽に計算できます。区切り済みの単語のリストを渡して使います。
from rank_bm25 import BM25Okapi

# 形態素解析などで、あらかじめ単語に区切っておく
docs = [
    ["有給", "休暇", "の", "申請", "は", "3", "日", "前", "まで"],
    ["パスワード", "の", "再", "設定", "手順"],
    ["エラー", "E-1024", "が", "出", "た", "場合", "の", "対処"],
]
bm25 = BM25Okapi(docs, k1=1.2, b=0.75)

query = ["E-1024", "エラー"]
print(bm25.get_scores(query))  # 3つ目の文書の点数が最も高くなる
BM25の考え方は、Robertsonらによる解説「The Probabilistic Relevance Framework: BM25 and Beyond」(2009年)に詳しくまとめられています。
https://nowpublishers.com/article/Details/INR-019
次の記事では、検索結果をさらに並べ替えて精度を上げるリランキングについて書く予定です。