 しがないRAG屋さん
ハイブリッド検索は、キーワード検索とベクトル検索を両方行い、その結果を1つにまとめる検索方法です。それぞれが苦手な検索をもう一方で補えるため、RAGの検索方法としてよく使われます。
前回の記事では、埋め込みを使ったベクトル検索を説明しました。
何のために使うのか
キーワード検索とベクトル検索には、それぞれ得意なことと苦手なことがあります。
| 検索方法 | 得意なこと | 苦手なこと |
|---|---|---|
| キーワード検索 | 型番、製品名、エラーコードなど、文字が一致することが大事な検索 | 言い換えや表記の違い |
| ベクトル検索 | 言い換えや、質問と資料で表現が違う場合 | 型番や固有名詞など、細かい文字の違いが大事な検索 |
たとえば「E-1024のエラーが出た」という質問では、ベクトル検索だと「E-1025」や別のエラーの説明が上位に来ることがあります。キーワード検索なら「E-1024」を含む資料を確実に見つけられます。逆に「休みを取りたい」という質問では、キーワード検索だと「有給休暇の申請」という資料を見つけられません。
両方を行えば、どちらの種類の質問にも対応しやすくなります。
どう動くのか
2つの検索を行う
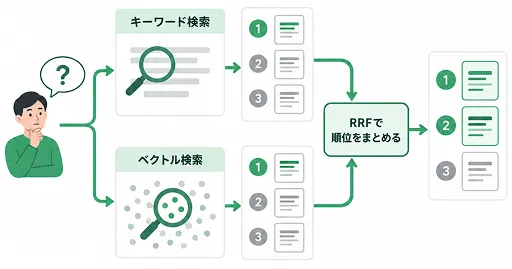
同じ質問で、キーワード検索とベクトル検索をそれぞれ行い、上位のチャンクを何件か取り出します。
キーワード検索には、BM25という方法がよく使われます。質問に含まれる単語が、その文書に何回出てくるか、また他の文書にはどれだけ少ないか(珍しい単語ほど重要とみなす)をもとに点数を付ける方法です。
日本語は単語の間に空白がないため、キーワード検索では文章を単語に区切る処理(形態素解析)や、数文字ずつに区切る処理(n-gram)が必要です。
2つの結果をまとめる
キーワード検索とベクトル検索では点数の付け方がまったく違うため、点数をそのまま足し合わせることはできません。そこで、点数ではなく順位を使ってまとめる「RRF(Reciprocal Rank Fusion)」がよく使われます。RRFは、2009年にCormackらがSIGIRで発表した方法です。

RRFでは、それぞれの検索結果で何位だったかをもとに、次の式で点数を計算し、合計の大きい順に並べ直します。
点数 = 1 / (60 + キーワード検索での順位) + 1 / (60 + ベクトル検索での順位)60は論文で使われた値で、Elasticsearchなどの検索エンジンでも初期値になっています。片方の検索にしか出てこなかったチャンクは、出てきた方の分だけを足します。両方の検索で上位に入ったチャンクほど、最終的な順位が上がります。
def rrf(results_list, k=60):
    scores = {}
    for results in results_list:            # 検索方法ごとの結果(上位から順に並んだID)
        for rank, doc_id in enumerate(results, start=1):
            scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank)
    return sorted(scores, key=scores.get, reverse=True)

merged = rrf([keyword_results, vector_results])
注意点
- 検索を2回行うぶん、処理が増える:キーワード検索用の索引と、ベクトル検索用のデータの両方を用意して更新する必要があります。
- 必ず精度が上がるとは限らない:資料や質問の種類によっては、片方だけのほうが良い場合もあります。実際の質問で検索結果を見比べて判断します。
- RRFは順位しか見ない:点数の差が大きくても小さくても、順位が同じなら同じ扱いになります。片方の検索をより重視したい場合は、重みを付けて足し合わせる方法もあります。
多くの検索エンジンやベクトルデータベースは、ハイブリッド検索とRRFを標準の機能として用意しています。次の記事では、キーワード検索でよく使われるBM25の仕組みについて書く予定です。