 しがないRAG屋さん
埋め込み(エンベディング)は、文章を数値の配列(ベクトル)に変換する処理です。意味が近い文章ほど、近いベクトルになるように作られています。RAGでは、質問に近いチャンクを探すためにこの性質を使います。
前回の記事では、資料をチャンクに分ける方法を説明しました。今回は、分けたチャンクを検索できる形にする処理です。
チャンク分割とは | しがないRAG屋さんRAGで資料を検索しやすくするためのチャンク分割について、主な分け方と、決めるときのポイントをまとめます。しがないRAG屋さん(rag-ya-san.com)
何のために使うのか
キーワード検索は、質問と同じ単語が含まれる文章を探します。そのため、次のような場合に見つけられません。
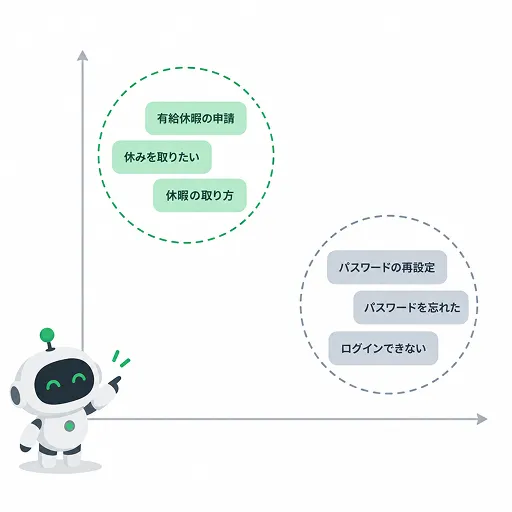
- 言い換え:「休みを取りたい」という質問で、「有給休暇の申請」と書かれた資料を探す
- 表記の違い:「サーバー」と「サーバ」、「問い合わせ」と「問合せ」
- 質問の形と資料の形の違い:「パスワードを忘れたら?」という質問と、「パスワードの再設定手順」という資料
埋め込みを使うと、単語が一致しなくても、意味が近い文章を探せるようになります。
どう動くのか
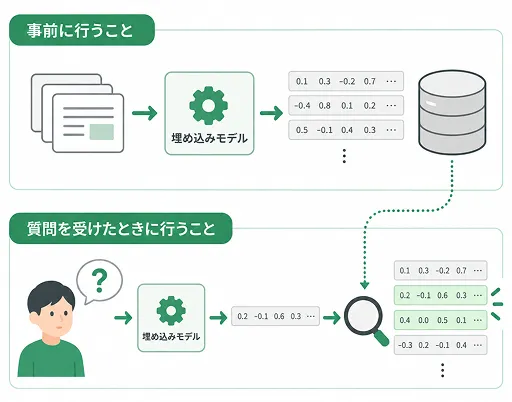
文章をベクトルに変換する
埋め込みモデルに文章を入力すると、決まった長さの数値の配列が返ってきます。たとえばOpenAIの text-embedding-3-small は、標準で1536個の数値を返します。
python
from openai import OpenAI

client = OpenAI()
response = client.embeddings.create(
    model="text-embedding-3-small",
    input="有給休暇の申請は3日前までに行ってください。",
)
vector = response.data[0].embedding
print(len(vector))  # 1536
1つ1つの数値が何を表すかは、人には分かりません。ただ、ベクトル全体として文章の意味を表していて、ベクトルどうしを比べることで意味の近さが分かります。
近さを測る
ベクトルの近さは、多くの場合「コサイン類似度」で測ります。2つのベクトルの向きがどれだけそろっているかを表す値で、1に近いほど意味が近いと判断します。
RAGでは、事前にすべてのチャンクをベクトルにして保存しておき、質問を受けたら質問もベクトルにして、コサイン類似度が高いチャンクを上から何件か取り出します。
モデルを選ぶときのポイント
- チャンクと質問は同じモデルでベクトルにする:モデルが違うとベクトルの作られ方が違うため、比べても意味がありません。モデルを変えたら、保存してあるチャンクもすべて作り直します。
- 日本語での性能を確認する:英語で評価の高いモデルが、日本語でも同じように良いとは限りません。日本語の埋め込みモデルの評価には、JMTEBというベンチマークがあります。
- 入力できる長さと次元数を確認する:モデルごとに一度に入力できる長さ(トークン数)が決まっていて、チャンクがそれを超えないようにする必要があります。また、次元数(数値の個数)が大きいほど保存に必要な容量が増えます。
埋め込みによる検索は言い換えに強い一方、型番や固有名詞のように文字が一致することが大事な検索は苦手な場合があります。次の記事では、キーワード検索と組み合わせるハイブリッド検索について書く予定です。