 しがないRAG屋さん
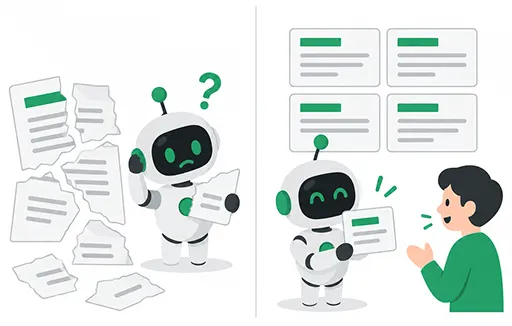
チャンク分割は、RAGで検索の対象にする資料を、小さな断片(チャンク)に分ける処理です。RAGでは、質問に近いチャンクを検索してLLMに渡すため、どう分けるかによって検索で見つかる内容が変わり、回答の質にも影響します。
RAG全体の流れは、次の記事で説明しています。
なぜ分けるのか
資料をそのまま使わずに分けるのには、次の理由があります。
- LLMに渡せる長さに上限がある:資料をまるごとプロンプトに入れることはできません。
- 質問に関係する部分だけを渡したい:関係のない文章が多いと、LLMが必要な情報を見落としやすくなります。
- 検索の精度を上げたい:1つのチャンクに複数の話題が混ざると、そのチャンクのベクトルがどの話題にも近くなりにくく、検索で見つかりにくくなります。
一方で、細かく分けすぎると、1つのチャンクだけでは意味が分からなくなります。大きすぎず小さすぎない分け方を探すことになります。
主な分け方
固定長で区切る
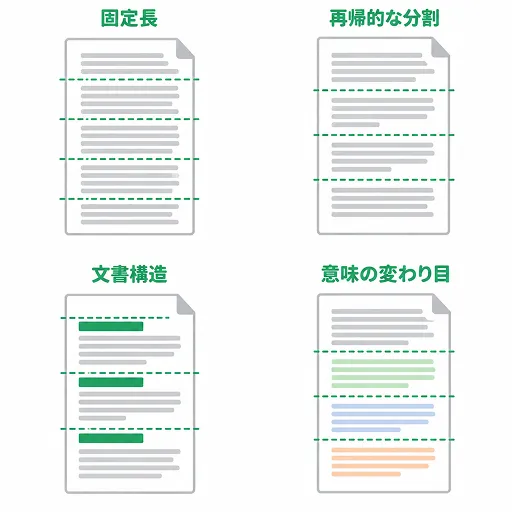
決まった文字数(またはトークン数)ごとに機械的に区切る方法です。実装が簡単ですが、文や段落の途中で切れることがあります。
切れ目で情報が失われるのを減らすため、隣り合うチャンクの一部を重ねる「オーバーラップ」を設定するのが一般的です。たとえば500文字ずつ区切り、前のチャンクの最後の50文字を次のチャンクの先頭にも入れる、といった形です。
段落や文の区切りを優先して区切る
段落、改行、文といった区切りを順番に試し、決めた文字数に収まるまで細かくしていく方法です。LangChainの RecursiveCharacterTextSplitter がこの方式で、一般的な文章に対して推奨されています。
from langchain_text_splitters import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,     # 1チャンクの最大文字数
    chunk_overlap=50,   # 隣のチャンクと重ねる文字数
    separators=["\n\n", "\n", "。", "、", ""],
)
chunks = splitter.split_text(text)
区切り文字の初期値は ["\n\n", "\n", " ", ""](段落、改行、空白、1文字)です。日本語の文章は単語の間に空白がないため、この例のように「。」や「、」を加えておくと、文の途中で切れにくくなります。
見出しなどの文書構造で区切る
Markdownの見出しやHTMLのタグなど、文書の構造をもとに区切る方法です。マニュアルや社内Wikiのように見出しが整っている資料では、話題のまとまりごとに分けやすくなります。1つの節が長すぎる場合は、さらに上の方法で細かく分けます。
意味の変わり目で区切る
文ごとに埋め込みベクトルを作り、隣り合う文のベクトルが大きく離れたところ(話題が変わったところ)で区切る方法です。セマンティックチャンキングとも呼ばれます。内容に沿って分けられる一方、すべての文をベクトル化するため、処理に時間と費用がかかります。
決めるときのポイント
- まずは段落や文の区切りを優先する方法から始める:多くの資料で無難に使えます。見出しが整った資料なら、文書構造で区切る方法も試します。
- チャンクの大きさに決まった正解はない:資料の種類や質問の傾向で変わります。いくつかの大きさで試し、検索結果を見比べて決めます。
- チャンクに見出しや文書名を付け加える:チャンク単体では何の話か分からないことがあるため、元の文書名や見出しを先頭に付けておくと、検索でもLLMでも理解しやすくなります。
分け方を変えたら、実際の質問でどのチャンクが検索されるかを確認するのが確実です。次の記事では、チャンクをベクトルに変換する埋め込みについて書く予定です。