 しがないRAG屋さん
LLM-as-a-Judgeは、LLMの回答の良し悪しを、別のLLM(判定用LLM)に採点させる評価方法です。人が1件ずつ読んで採点する代わりに、評価基準を書いたプロンプトと一緒に回答をLLMに渡し、点数や判定理由を出力させます。
この呼び方は、2023年にZhengらが発表した論文で広く知られるようになりました。この論文では、GPT-4を判定役にした場合、人の判定との一致率が80%を超え、人どうしの一致率と同じくらいになったと報告しています。

前回の記事では、RAGの評価の全体像と、Ragasの指標を説明しました。Ragasの指標の多くも、内部ではLLM-as-a-Judgeの考え方で計算されています。
何のために使うのか
LLMの回答の評価には、次のような難しさがあります。
- 人が採点すると時間と費用がかかる:設定を変えるたびに数百件の回答を読むのは続きません。
- 文字列の一致では測れない:同じ内容でも言い回しはいくらでも変わるため、正解の文章と文字が一致するかで判定する方法(BLEUなど)では、回答の正しさを測れません。
- 評価の観点が複数ある:資料に基づいているか、質問に答えているか、分かりやすいかなど、見るべき点がいくつもあります。
LLM-as-a-Judgeを使うと、文章の意味を理解したうえでの採点を、自動で大量に行えます。人は、判定用LLMの採点が正しいかを抜き取りで確認する役に回れます。
判定の3つの方式
Zhengらの論文では、判定の方式を次の3つに分けています。
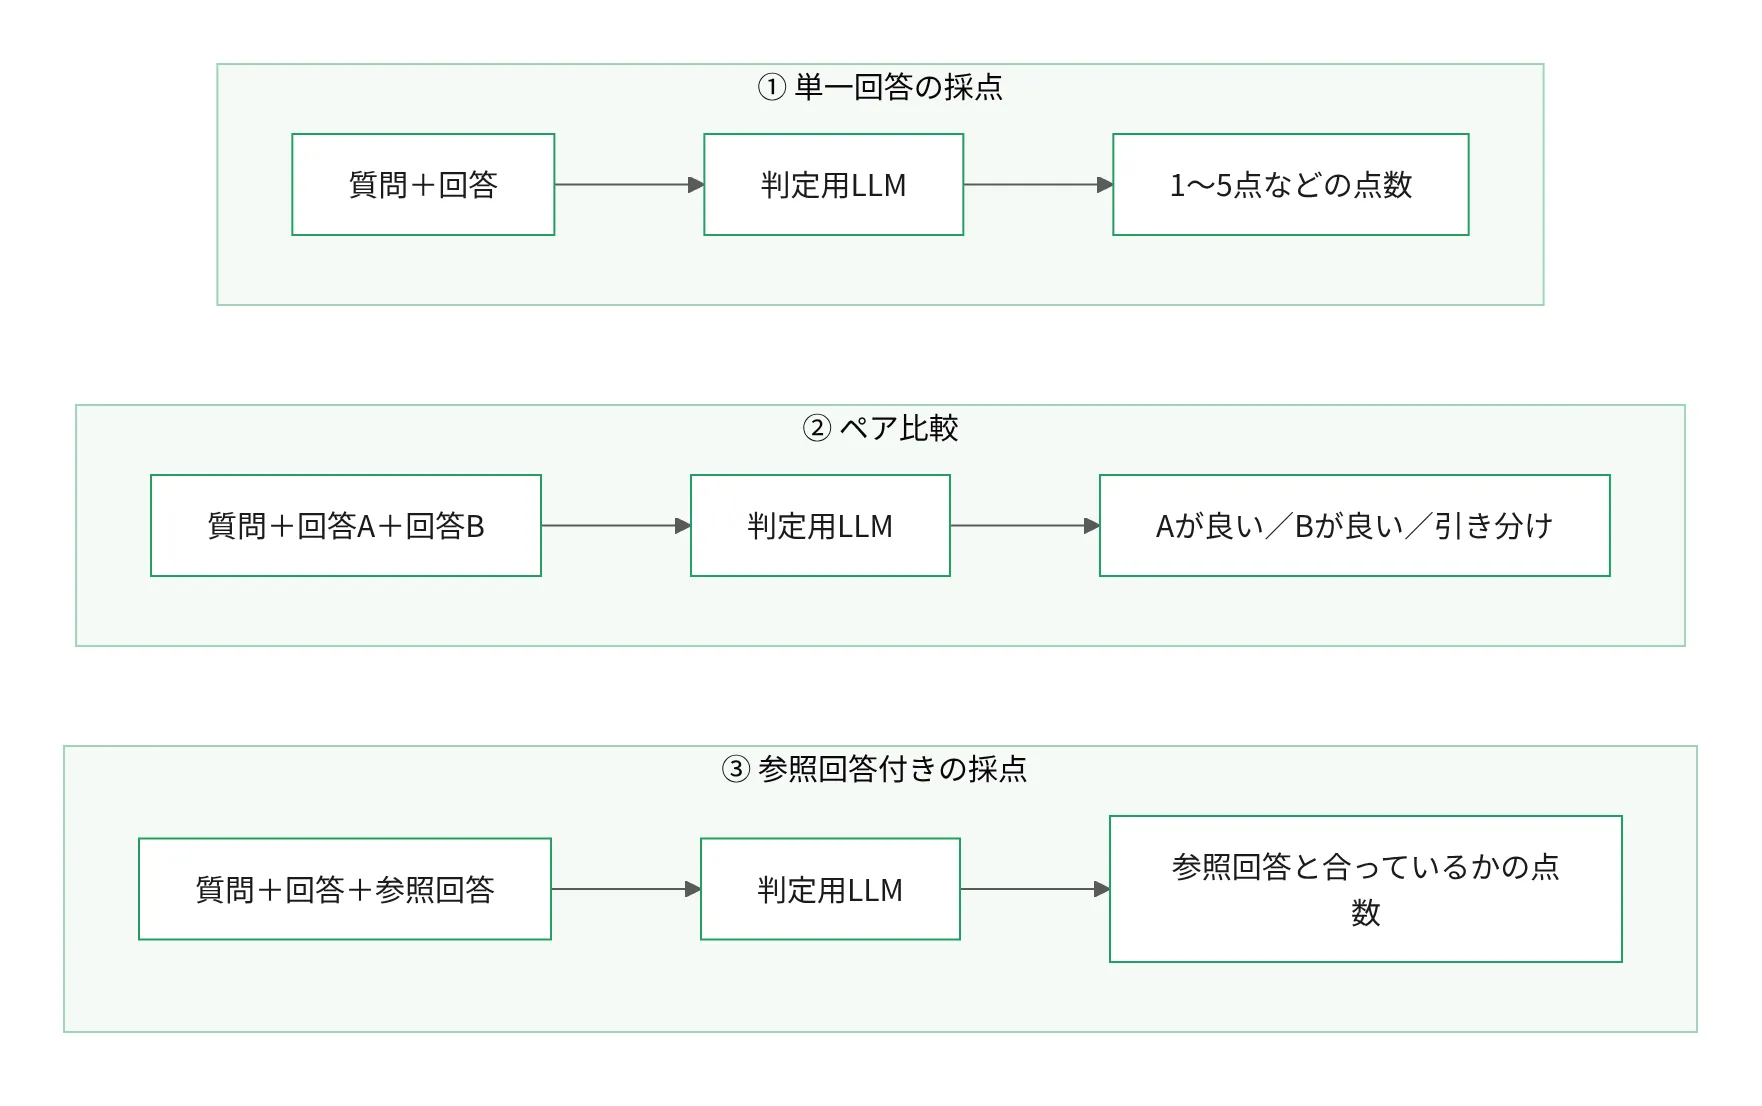
| 方式 | 判定用LLMに渡すもの | 出力 | 向いている用途 |
|---|---|---|---|
| 単一回答の採点 | 質問、回答 | 1〜5点などの点数 | 1つの設定の品質を継続的に測る |
| ペア比較 | 質問、回答A、回答B | どちらが良いか(または引き分け) | 2つの設定やモデルを比べる |
| 参照回答付きの採点 | 質問、回答、参照回答 | 参照回答と合っているかの点数 | 正解がはっきりしている質問 |
RAGの評価では、これに「検索結果」を加えて渡すことが多いです。たとえば、回答が検索結果に書かれている内容だけで作られているか(Ragasでいう Faithfulness)を判定するには、回答と検索結果の両方が必要です。
評価の仕組みの全体像
RAGをLLM-as-a-Judgeで評価する仕組みは、次のようになります。
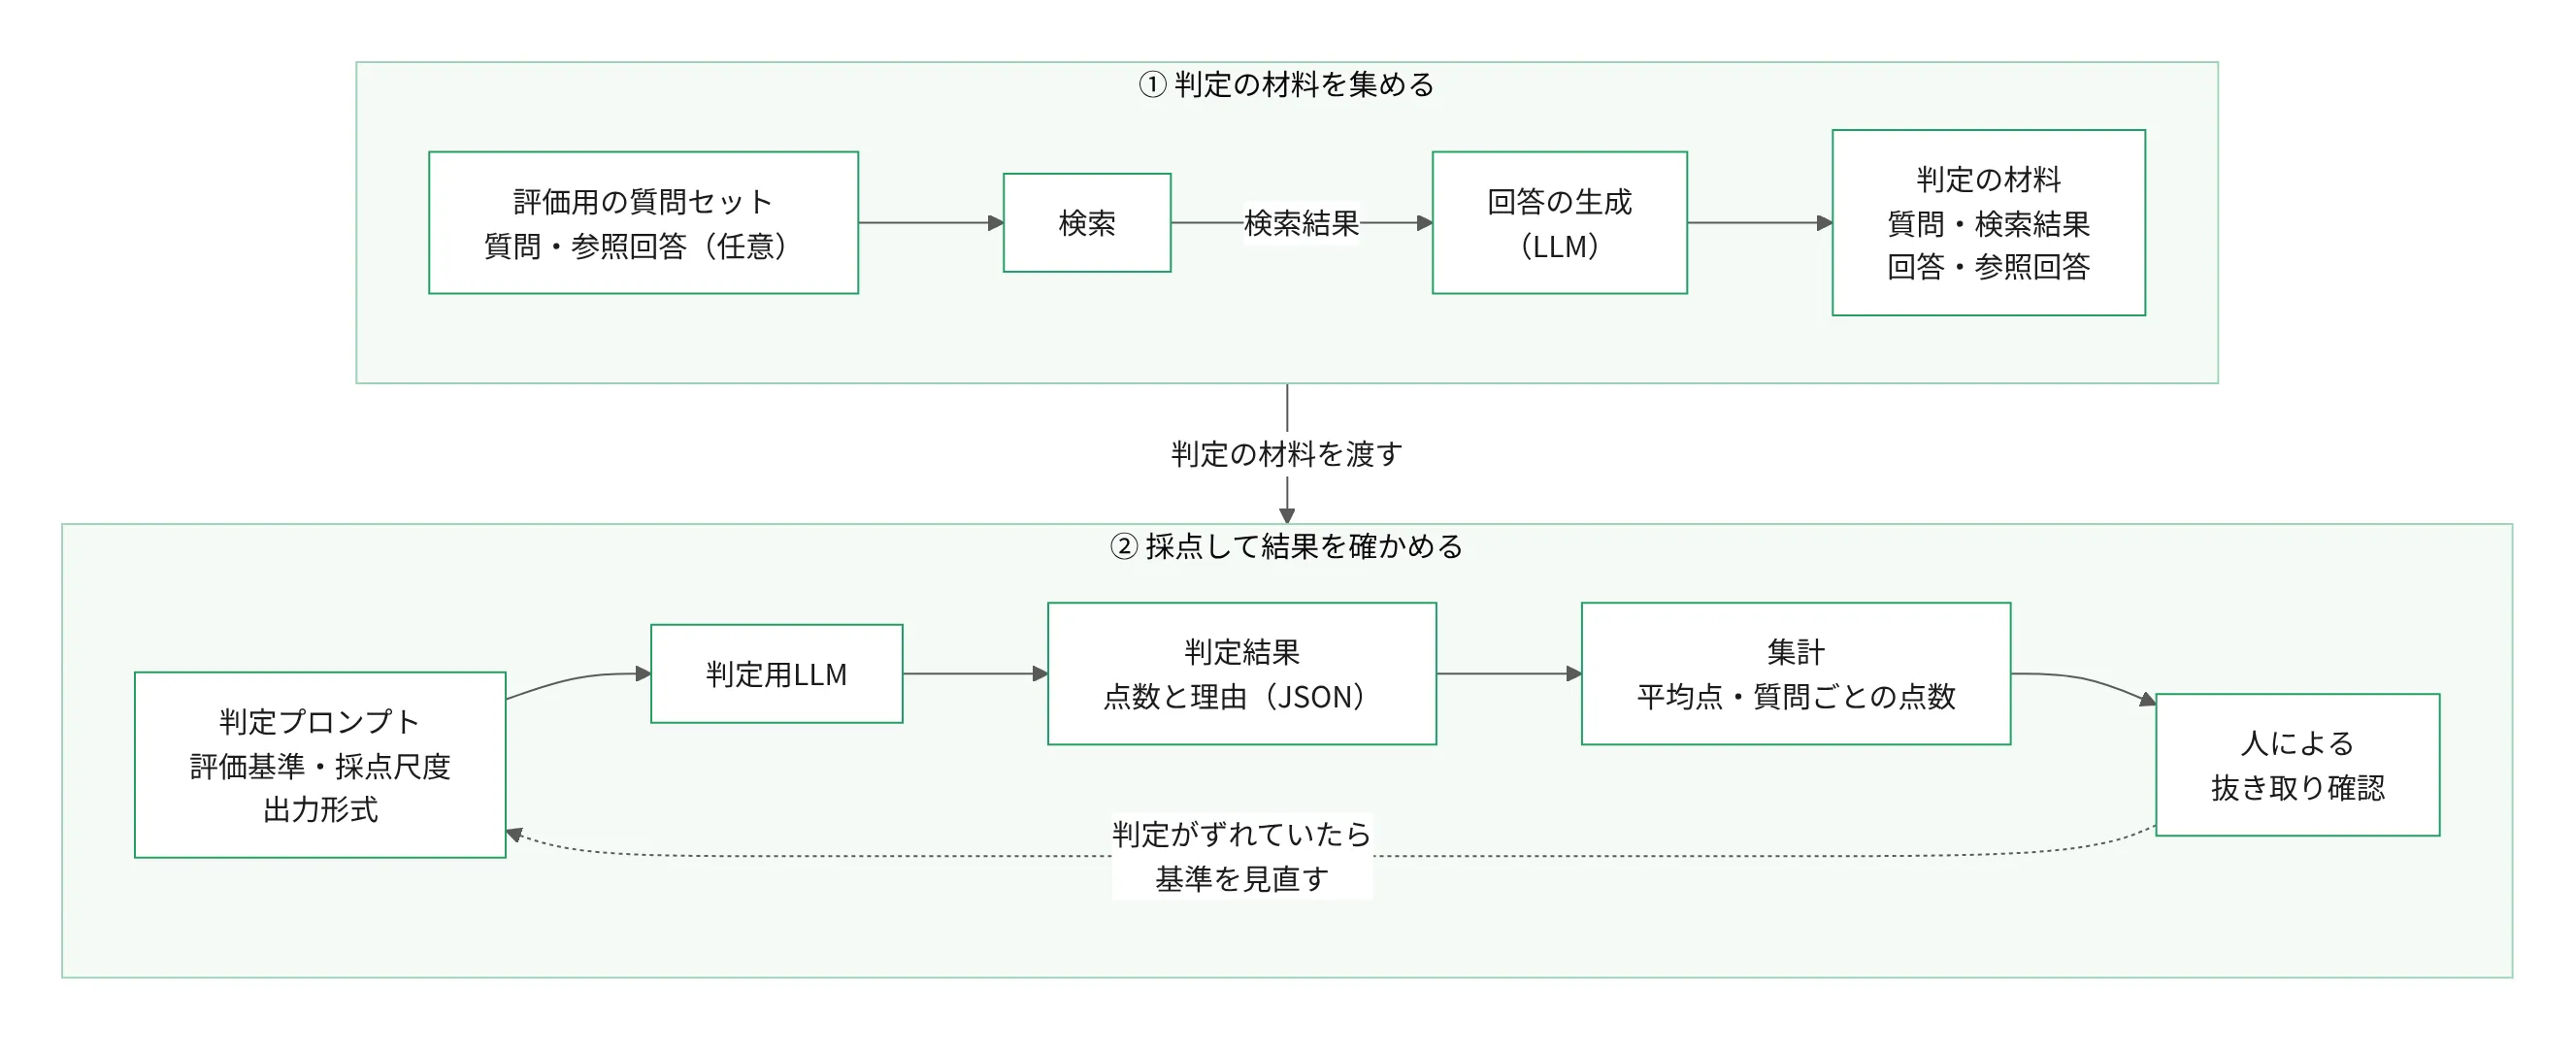
- 評価用の質問セットをRAGに入力し、質問ごとに検索結果と回答を記録する
- 判定プロンプトに、質問・検索結果・回答(あれば参照回答)を埋め込んで、判定用LLMに渡す
- 判定用LLMから、点数と理由をJSONなどの決まった形式で受け取る
- 点数を集計し、平均点や点数の低い質問を確認する
- 人が一部の判定結果を読んで確かめ、判定がずれていれば判定プロンプトを直す
最後の5を省かないことが大切です。判定用LLMの採点が人の感覚とずれたままだと、点数が上がっても実際の品質は上がっていない、ということが起こります。
判定プロンプトの書き方
判定の質は、判定プロンプトの書き方で大きく変わります。次の点を押さえます。
- 評価の観点を1つに絞る:「正確さ」と「分かりやすさ」を1回の判定でまとめて採点させると、基準があいまいになります。観点ごとに別の判定にします。
- 点数ごとの基準を具体的に書く:「1点:資料にない内容が含まれる」「5点:すべての内容が資料で確認できる」のように、各点数の意味を書きます。
- 理由を先に書かせてから点数を出させる:先に点数を出させると、理由が点数に合わせた後付けになりやすいためです。
- 出力形式を決める:JSONなどで出力させると、集計の処理が簡単になります。
RAGの回答が検索結果に基づいているかを判定するプロンプトの例です。
あなたは、質問応答システムの回答を評価する担当者です。
次の「資料」と「回答」を読み、回答の内容が資料だけで裏付けられるかを評価してください。

# 評価基準
5点:回答のすべての内容が、資料で確認できる
4点:ほぼすべての内容が資料で確認できるが、細かい補足が資料にない
3点:主な内容は資料で確認できるが、資料にない説明が一部含まれる
2点:資料にない内容が多く含まれる
1点:回答の主な内容が資料と食い違う、または資料に書かれていない

# 資料
{検索結果}

# 質問
{質問}

# 回答
{回答}

# 出力形式
次のJSONだけを出力してください。
{"reason": "判断の理由", "score": 1から5の整数}
判定のたびに結果が変わらないように、判定用LLMの温度(temperature)は0など低い値にしておくのが一般的です。
判定の偏りと対策
判定用LLMの採点には、人とは違う偏りがあることが分かっています。Zhengらの論文では、主に次の偏りが報告されています。
- 位置の偏り(position bias):ペア比較で、内容に関係なく、先に(または後に)示された回答を選びやすい傾向です。
- 長さの偏り(verbosity bias):内容が同じでも、長くて詳しく見える回答を高く評価しやすい傾向です。
- 自分の回答をひいきする偏り(self-enhancement bias):判定用LLMが、自分自身が生成した回答を高く評価する傾向です。論文では、この傾向が見られるものの、データからは断定できないとしています。
- 計算や推論の採点が苦手:数学や推論の問題では、判定用LLMが自分では解ける問題でも、渡された回答に引きずられて誤った採点をすることがあります。
位置の偏りへの対策
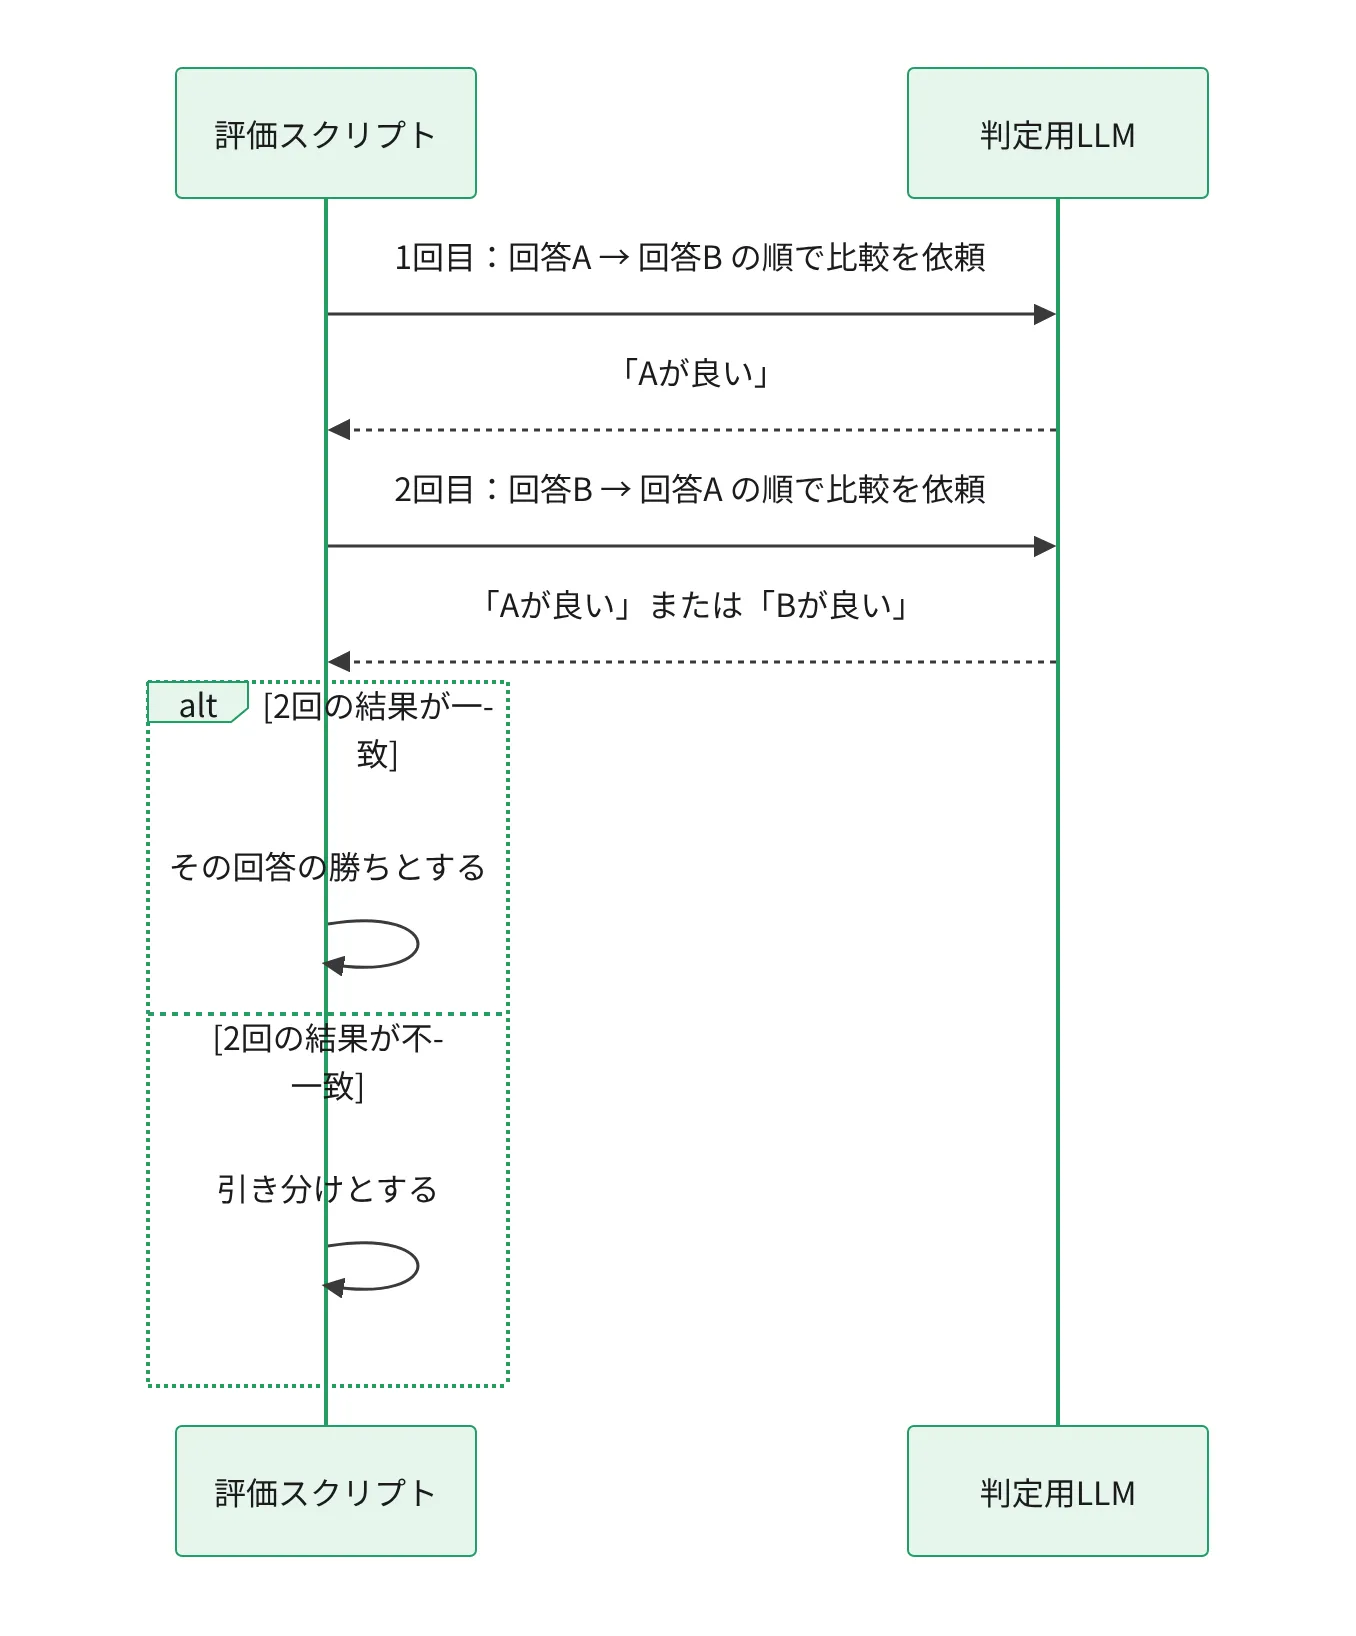
ペア比較では、回答の順番を入れ替えて2回判定させ、2回とも同じ回答を選んだときだけ勝ちとし、結果が変わった場合は引き分けとする方法があります。
def compare(question, answer_a, answer_b):
    first = judge_pair(question, answer_a, answer_b)   # "first" / "second" / "tie" を返す
    second = judge_pair(question, answer_b, answer_a)  # 順番を入れ替えてもう一度

    if first == "first" and second == "second":
        return "A"
    if first == "second" and second == "first":
        return "B"
    return "tie"  # 順番で結果が変わった場合は引き分け
そのほかの偏りへの対策
- 長さの偏り:評価基準に「長さや詳しさでは評価しない」と明記します。点数と回答の長さの関係を確認し、長い回答ほど点数が高くなっていないかも見ます。
- 自分の回答をひいきする偏り:評価対象のRAGで使っているLLMとは別のモデルを判定用LLMに使います。
- 計算や推論の採点:参照回答付きの採点にして、正しい答えを判定用LLMに渡します。論文でも、参照回答を渡すことで数学の問題の誤判定が大きく減ったと報告されています。
判定の精度を確かめる
判定用LLMを使い始める前に、その判定が人の判定とどれだけ一致するかを確かめておきます。
- 評価用の質問から数十件を選び、人が採点する
- 同じ回答を判定用LLMにも採点させる
- 人の採点と判定用LLMの採点がどれだけ一致するかを確認する
- 一致しない回答を読み、判定プロンプトの基準を直す
一致率が十分に高くなってから、判定用LLMによる評価を本格的に使います。判定用LLMのモデルや判定プロンプトを変えたときも、同じ確認を行います。
注意点
- 判定にも費用と時間がかかる:質問の数 × 観点の数 × 判定の回数だけLLMを呼び出します。ペア比較で順番を入れ替える場合は、さらに2倍になります。
- 点数は比較のための目安:判定用LLMの点数そのものに絶対的な意味はありません。同じ判定用LLMと判定プロンプトで、設定を変えた前後を比べるために使います。
- 専門的な内容は人の確認が欠かせない:医療、法律、社内の専門知識など、判定用LLMが正しく判断できない分野では、専門の人による確認が必要です。
LLM-as-a-Judgeは、仕組み自体は「評価基準を書いたプロンプトでLLMに採点させる」という単純なものです。ただし、判定の偏りがあることを前提に、人の判定と照らし合わせながら使うことで、はじめて信頼できる評価になります。