 しがないRAG屋さん
RAGの評価は、RAGが質問に対してどれだけ正しく答えられているかを、数値などで確かめる作業です。チャンクの分け方や検索方法を変えたときに、本当に良くなったのかを判断するために必要です。
これまでの記事では、チャンク分割、埋め込み、ハイブリッド検索、BM25、リランキングと、RAGの精度を上げる方法を説明してきました。
何のために使うのか
評価の仕組みがないと、次のような問題が起きます。
- 改善したかどうか分からない:いくつかの質問を試して「良くなった気がする」で判断することになり、別の質問では悪くなっていても気づけません。
- どこが悪いのか分からない:回答が間違っていたとき、検索で必要なチャンクが見つかっていないのか、見つかっているのにLLMが読み違えたのかで、直すべき場所が違います。
- 変更のたびに確認が大変:モデルや設定を変えるたびに、人がすべての回答を読んで確認するのは続きません。
決まった質問のセットと指標を用意しておくと、変更の前後を同じ条件で比べられます。
どう動くのか
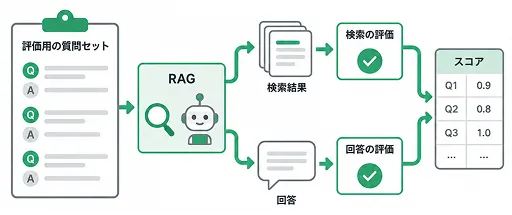
1. 評価用の質問セットを作る
まず、実際に聞かれそうな質問と、その正しい答え(または答えが書かれている資料)の組を用意します。最初は数十件程度でもかまいません。答えのない質問(資料に書かれていないこと)も入れておくと、「分かりません」と答えられるかも確認できます。
2. 検索と回答を分けて評価する
RAGの評価では、検索と回答生成を分けて見るのが基本です。どちらに問題があるかで、直す場所が変わるためです。
検索の評価では、質問に答えるために必要なチャンクが検索結果に入っているか、上位に来ているかを見ます。
回答の評価では、主に次の2点を見ます。
- 回答が、検索で渡したチャンクの内容に基づいているか(チャンクに書かれていないことを付け加えていないか)
- 回答が、質問にきちんと答えているか
3. よく使われる指標
RAGの評価用のライブラリとして、Ragasがよく使われています。Ragasは、2023年にEsらが発表した論文がもとになっていて、正解の回答を人が用意しなくても一部の指標を計算できるように作られています。

Ragasの主な指標は次のとおりです。
| 指標 | 何を見るか | 対象 |
|---|---|---|
| Context Precision | 関係のあるチャンクが、関係のないチャンクより上位に来ているか | 検索 |
| Context Recall | 答えに必要な情報が、検索結果に含まれているか | 検索 |
| Faithfulness | 回答の内容が、検索結果のチャンクで裏付けられるか | 回答 |
| Response Relevancy | 回答が質問に合っているか | 回答 |
たとえばFaithfulnessは、回答を1つ1つの主張に分け、そのうち検索結果から確認できる主張の割合を0から1の値で出します。こうした判定には、LLMを判定役として使います。
注意点
- LLMによる判定も間違えることがある:指標の計算にLLMを使う場合、その判定自体が正しいとは限りません。点数だけを見ず、点数の低い質問は人が実際に回答を読んで確認します。
- 質問セットが実際の使われ方とずれていると意味がない:作りやすい質問だけを集めると、実際の利用者の質問では精度が出ないことがあります。可能なら、実際に寄せられた質問をもとに作ります。
- 一度に変える設定は1つにする:チャンクの大きさと検索方法を同時に変えると、どちらの効果で点数が変わったのか分かりません。
評価の仕組みを作っておくと、このブログでこれまで説明してきた方法を、自分の資料で試して比べられるようになります。今後は、実際に手元の資料で設定を変えながら、評価の結果を記事にしていく予定です。