 しがないRAG屋さん
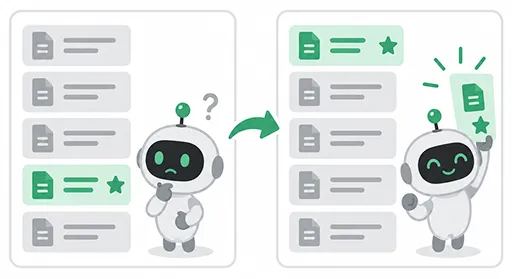
リランキングは、検索で取り出したチャンクを、より精度の高いモデルで点数を付け直して並べ替える処理です。検索の後、LLMに渡す前に1段階追加することで、質問に本当に関係するチャンクを上位に集めます。
これまでの記事では、ベクトル検索、BM25、その2つを組み合わせるハイブリッド検索を説明しました。
何のために使うのか
ベクトル検索やBM25は、大量の資料から高速に探せるように作られています。その代わり、次のような問題が起きることがあります。
- 関係の薄いチャンクが上位に来る:単語や話題が似ているだけで、質問の答えになっていないチャンクが選ばれる
- 本当に必要なチャンクが少し下の順位にある:上位5件だけをLLMに渡すと、6位以下にあった答えが使われない
- LLMに渡す件数を増やすと、関係のない文章も増える:プロンプトが長くなり、費用も上がり、LLMが必要な情報を見落としやすくなる
リランキングを入れると、「広めに検索して、精度の高いモデルで絞り込む」ことができます。
どう動くのか
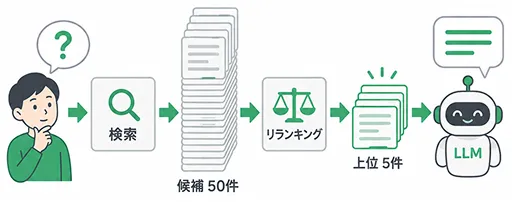
1. 検索で候補を多めに取り出す
まず、ベクトル検索やハイブリッド検索で、LLMに渡す件数より多めに候補を取り出します。たとえば、最終的に5件渡すなら、検索では50件程度を取り出しておきます。
2. リランカーで点数を付け直す
取り出した候補それぞれについて、質問とチャンクの組をリランカー(リランキング用のモデル)に入力し、関係の深さを点数にします。点数の高い順に並べ替え、上位の数件だけをLLMに渡します。
なぜ精度が上がるのか
ベクトル検索で使う埋め込みモデルは、質問とチャンクを別々にベクトルにしてから比べます。チャンクのベクトルは事前に作っておけるので高速ですが、質問とチャンクの細かい関係までは見ていません。
リランカーの多くは「クロスエンコーダー」という種類のモデルで、質問とチャンクを1つの入力としてまとめて読み、関係の深さを判断します。そのため精度が高い一方、質問のたびに候補の数だけモデルを動かす必要があり、時間がかかります。すべての資料に使うのではなく、検索で絞った候補にだけ使うのはこのためです。
Pythonでは、sentence-transformers の CrossEncoder で試せます。日本語用に学習されたリランカーも公開されています。
from sentence_transformers import CrossEncoder

model = CrossEncoder("hotchpotch/japanese-reranker-cross-encoder-small-v1", max_length=512)

query = "有給休暇は何日前までに申請すればよいですか"
candidates = [
    "有給休暇の申請は、取得日の3日前までに行ってください。",
    "休暇中の緊急連絡先は、事前に上長へ伝えてください。",
    "パスワードの再設定は、ログイン画面から行えます。",
]
scores = model.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: x[1], reverse=True)
注意点
- 応答が遅くなる:候補の数だけモデルを動かすため、候補を増やすほど時間がかかります。候補の件数と、かかる時間のバランスを見て決めます。
- 検索で見つからなかったものは拾えない:リランキングは候補の並べ替えなので、最初の検索で候補に入らなかったチャンクは上位に来ません。検索の精度も引き続き大切です。
- 日本語での性能を確認する:英語で学習されたリランカーは、日本語では精度が出ないことがあります。日本語のリランキングの評価には、JQaRAなどのベンチマークがあります。
リランキングは、既存の検索の後ろに1段階足すだけで試せるため、検索の精度に不満があるときに最初に試しやすい方法です。次の記事では、RAGの回答の良し悪しをどう測るか、評価の方法について書く予定です。